# DeepSeek DualPath offre un débit x2 pour les agents IA sans GPU supplémentaire
**Date:** 13 octobre 2026
**Source:** [PIX GEEKS](https://pix-geeks.com)
**Catégories:** [High-Tech](https://pix-geeks.com/tech/) > [Intelligence Artificielle](https://pix-geeks.com/tech/intelligence-artificielle/)
**Marques:** [DeepSeek](https://pix-geeks.com/marque/deepseek/)
**Entités principales:** Organization: [DeepSeek](http://www.wikidata.org/entity/Q131577453) | Place: [Tsinghua](http://www.wikidata.org/entity/Q16955) | Corporation: [DeepSeek](http://www.wikidata.org/entity/Q131577453)
**Entités secondaires:** Place: [Pékin](http://www.wikidata.org/entity/Q956), [InfiniBand](http://www.wikidata.org/entity/Q922437) | Intangible: [Intelligence Artificielle](https://www.wikidata.org/wiki/Q11660)
**Un second chemin pour charger le cache des modèles de langage annonce 1,87 fois plus de débit hors ligne et 1,96 fois en moyenne en service en ligne. Ces gains concernent les agents IA, pas toute l’IA, et se mesurent face à un système interne.**
DualPath est décrit dans un [article déposé sur arXiv le 25 février 2026](https://arxiv.org/abs/2602.21548) par des chercheurs de DeepSeek, de l’université de Pékin et de Tsinghua. Il ne s’agit pas d’un nouveau modèle, mais de la plomberie qui fait tourner les assistants capables d’enchaîner les tâches : comment éviter que des GPU attendent des données au lieu de calculer ?
## Agents IA : le cache KV, goulot d’étranglement de l’inférence
Un agent multi-tours, un assistant de code par exemple, réutilise presque tout son contexte à chaque échange. Sur une trace de tâches de codage citée par les auteurs, le cache KV est réutilisé dans 98,7 % des cas.
Le travail consiste donc moins à calculer qu’à recharger ce cache depuis le stockage.
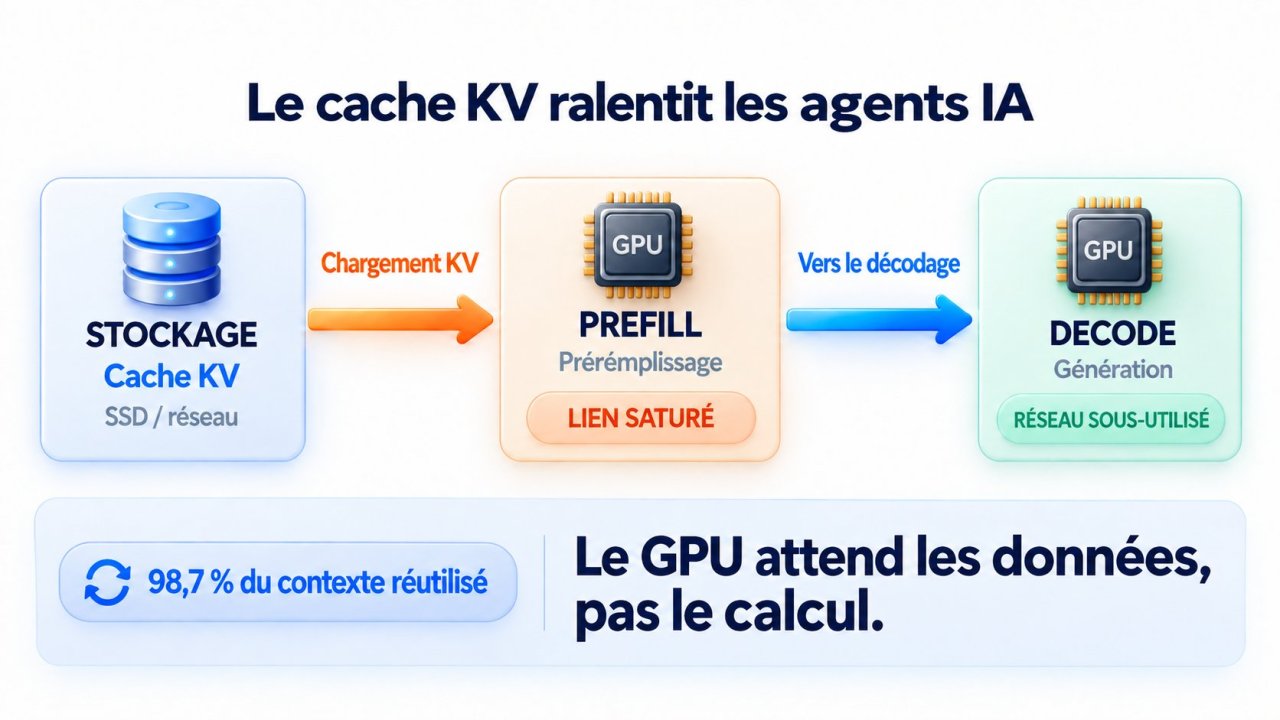
Le problème se corse dans les architectures « désagrégées », qui séparent les moteurs de préremplissage (prefill) et de décodage (decode). Les cartes réseau de stockage des premiers saturent, alors que celles des seconds restent largement inactives : de la bande passante existe, mais on ne s’en sert pas.
## DualPath charge le cache par les moteurs de décodage, puis le transfér en RDMA
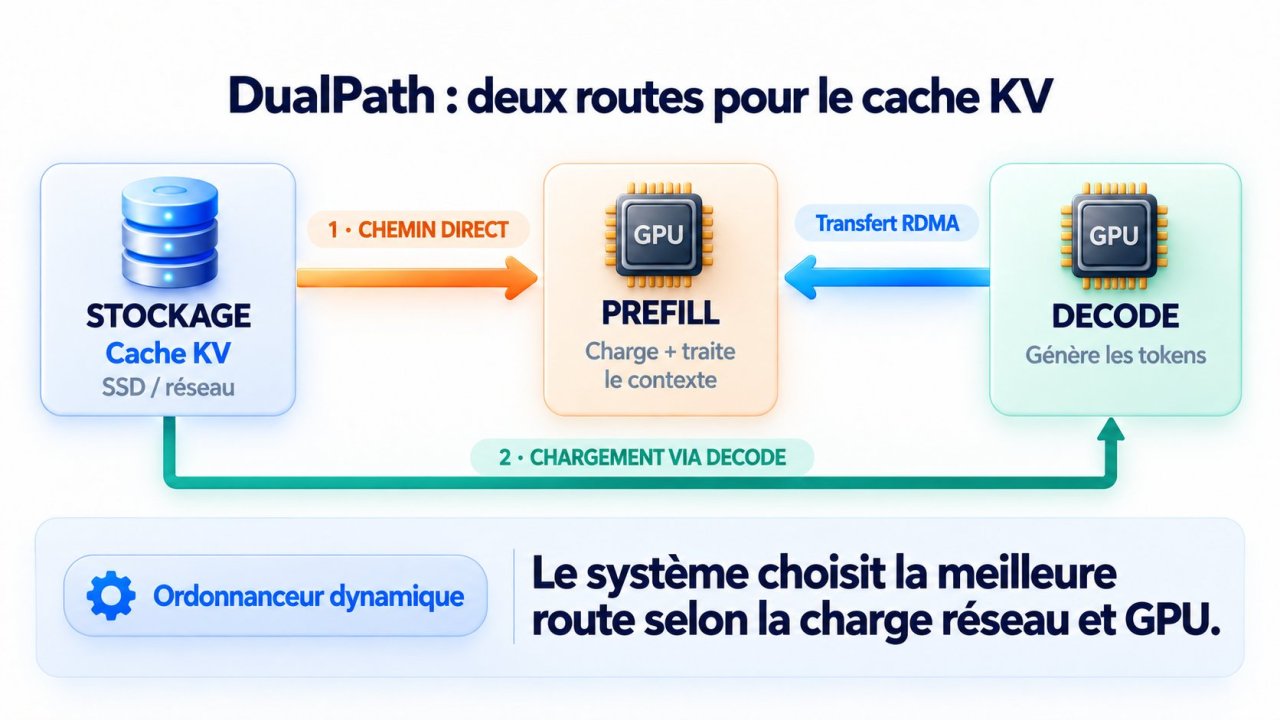
Le système décrit par les ingénieurs de DeepSeek ajoute un second chemin :
- le cache est d’abord chargé dans un moteur de décodage
- puis envoyé au moteur de préremplissage par RDMA, sur le réseau de calcul
- et un ordonnanceur choisit dynamiquement la route, ce qui additionne la bande passante de stockage de tous les moteurs
Pour ne pas perturber les échanges du modèle, ce trafic passe par des voies virtuelles InfiniBand, dont environ 99 % de la bande passante reste réservée à l’inférence.
## 1,87 fois hors ligne, 1,96 fois en ligne : ce que mesure le « x2 »
Les chiffres évoqués sont très prometteurs : jusqu’à 1,[87 fois plus de débit](https://pix-geeks.com/maia-300-microsoft-puce-ia-2-nm-dependre-nvidia/) hors ligne sur DeepSeek V3.2 (660 milliards de paramètres), et 1,96 fois en moyenne pour le service en ligne. Ce second chiffre mesure le nombre d’agents servis par seconde sous contraintes de latence : 1,67 fois pour un modèle interne de 27 milliards de paramètres, 2,25 fois pour le 660B. Qwen2.5-32B a aussi été testé, et les essais à grande échelle vont jusqu’à 1 152 GPU.
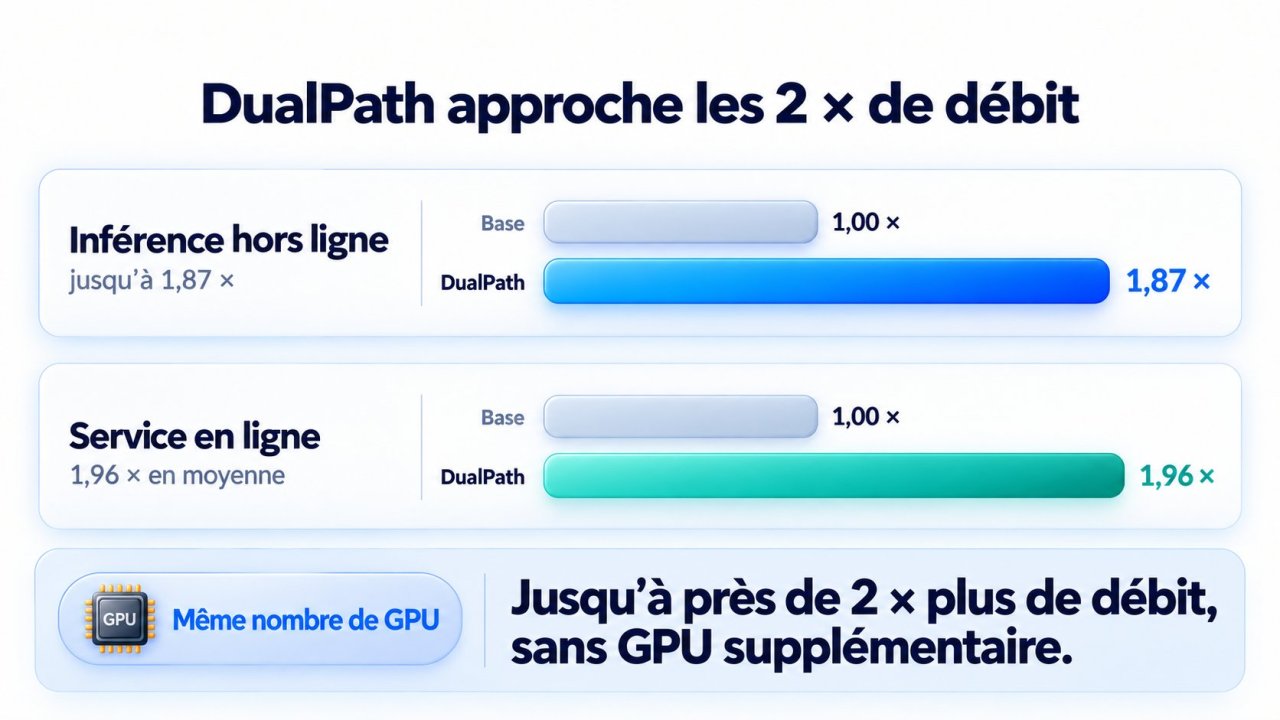
« Sans GPU supplémentaire » est exact, à une condition : ces serveurs à 8 GPU Nvidia Hopper sont reliés par un réseau InfiniBand et un stockage rapide, et l’extension à RoCE n’est pas évaluée. La référence, ensuite, est le framework interne de DeepSeek non modifié : les auteurs jugent eux-mêmes une comparaison directe avec SGLang inéquitable.
Les jeux de données sont des traces internes de 500 trajectoires, mesurées avec une latence d’appel d’outils nulle, ce qui sous-estime l’usage réel. Sur le 27B en configuration 1P1D, DualPath reste d’ailleurs de 1,09 à 1,85 fois plus lent que le cas idéal sans entrées-sorties.
Aucune reproduction indépendante ne figure dans les sources consultées. Ces gains tiendront-ils hors des clusters de DeepSeek ?
[!\[YouTube video thumbnail\](https://pix-geeks.com/wp-content/uwkmsq-1894/pxnetwork-frontoffice-wp-youtube-lyte/lyteCache.php?origThumbUrl=https%3A%2F%2Fi.ytimg.com%2Fvi%2Fep_XtuAVf80%2F0.jpg)
Lire cette vidéo sur YouTube](https://youtu.be/ep_XtuAVf80)
[Vidéo YouTube](https://www.youtube.com/watch?v=ep_XtuAVf80)
---
**Article précédent:** [Maia 300 : Microsoft dévoile une puce IA 2 nm pour moins dépendre de Nvidia](https://pix-geeks.com/maia-300-microsoft-puce-ia-2-nm-dependre-nvidia/)