# GitHub Copilot HydraFusion permet de faire 67% d’économie sur votre facture IA
**Date:** 11 octobre 2026
**Source:** [PIX GEEKS](https://pix-geeks.com)
**Catégories:** [High-Tech](https://pix-geeks.com/tech/) > [Intelligence Artificielle](https://pix-geeks.com/tech/intelligence-artificielle/)
**Marques:** [GitHub](https://pix-geeks.com/marque/github/)
**Entités principales:** SoftwareApplication: [GitHub Copilot](http://www.wikidata.org/entity/Q107435063)
**Entités secondaires:** SoftwareApplication: [Claude Opus](http://www.wikidata.org/entity/Q134885159) | Intangible: [Intelligence Artificielle](https://www.wikidata.org/wiki/Q11660)
**Project HydraFusion n’est pas un modèle de plus dans le sélecteur de GitHub Copilot : c’est un orchestrateur qui décide, à chaque prompt, combien de modèles mobiliser et dans quel ordre. Face aux routeurs d’OpenRouter, il pose la même question sous un autre angle : un seul modèle suffit-il, ou faut-il en faire travailler plusieurs ?**
- HydraFusion orchestre l'utilisation de plusieurs modèles en fonction du prompt, pour réduire les coûts.
- Il propose trois schémas d'exécution : Single, Cascade et Critique, adaptés selon la tâche.
- Les économies peuvent atteindre 67 %, mais leur fiabilité dépend des tests indépendants et des configurations.
GitHub a présenté Project HydraFusion le 4 septembre 2026, en « research preview » dans Copilot. Dans [son billet de lancement](https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/), l’entreprise décrit un système qui orchestre des modèles à l’exécution et renvoie une seule réponse : l’utilisateur le choisit dans le sélecteur de modèles, mais ne choisit ni les modèles, ni le nombre d’appels.
Au départ réservé à Copilot CLI, il a été ouvert le 30 septembre 2026 à VS Code (version 1.140 ou plus récente) et à l’app GitHub Copilot, pour les formules Pro, Pro+, Business et Enterprise.
## HydraFusion choisit Single, Cascade ou Critique à chaque prompt
La [documentation de GitHub](https://docs.github.com/en/early-access/copilot/hydrafusion) décrit trois schémas d’exécution :
- **Single** : un seul modèle traite la tâche
- **Cascade** : un modèle efficace rédige, puis une « porte de qualité » décide d’accepter le brouillon ou de l’escalader vers un modèle plus fort
- **Critique** : un modèle rédige, un critique en lecture seule, issu d’une autre famille de modèles, relit, et le modèle initial révise une seule fois
Le schéma est choisi pour chaque prompt : dans une même session, le premier peut partir en Single et le suivant en Critique. Cette étape de choix est légère et ne génère aucune partie de la réponse. GitHub affirme retenir le workflow le moins complexe censé suffire, et n’ajouter des appels que s’ils ont de bonnes chances d’améliorer le résultat.
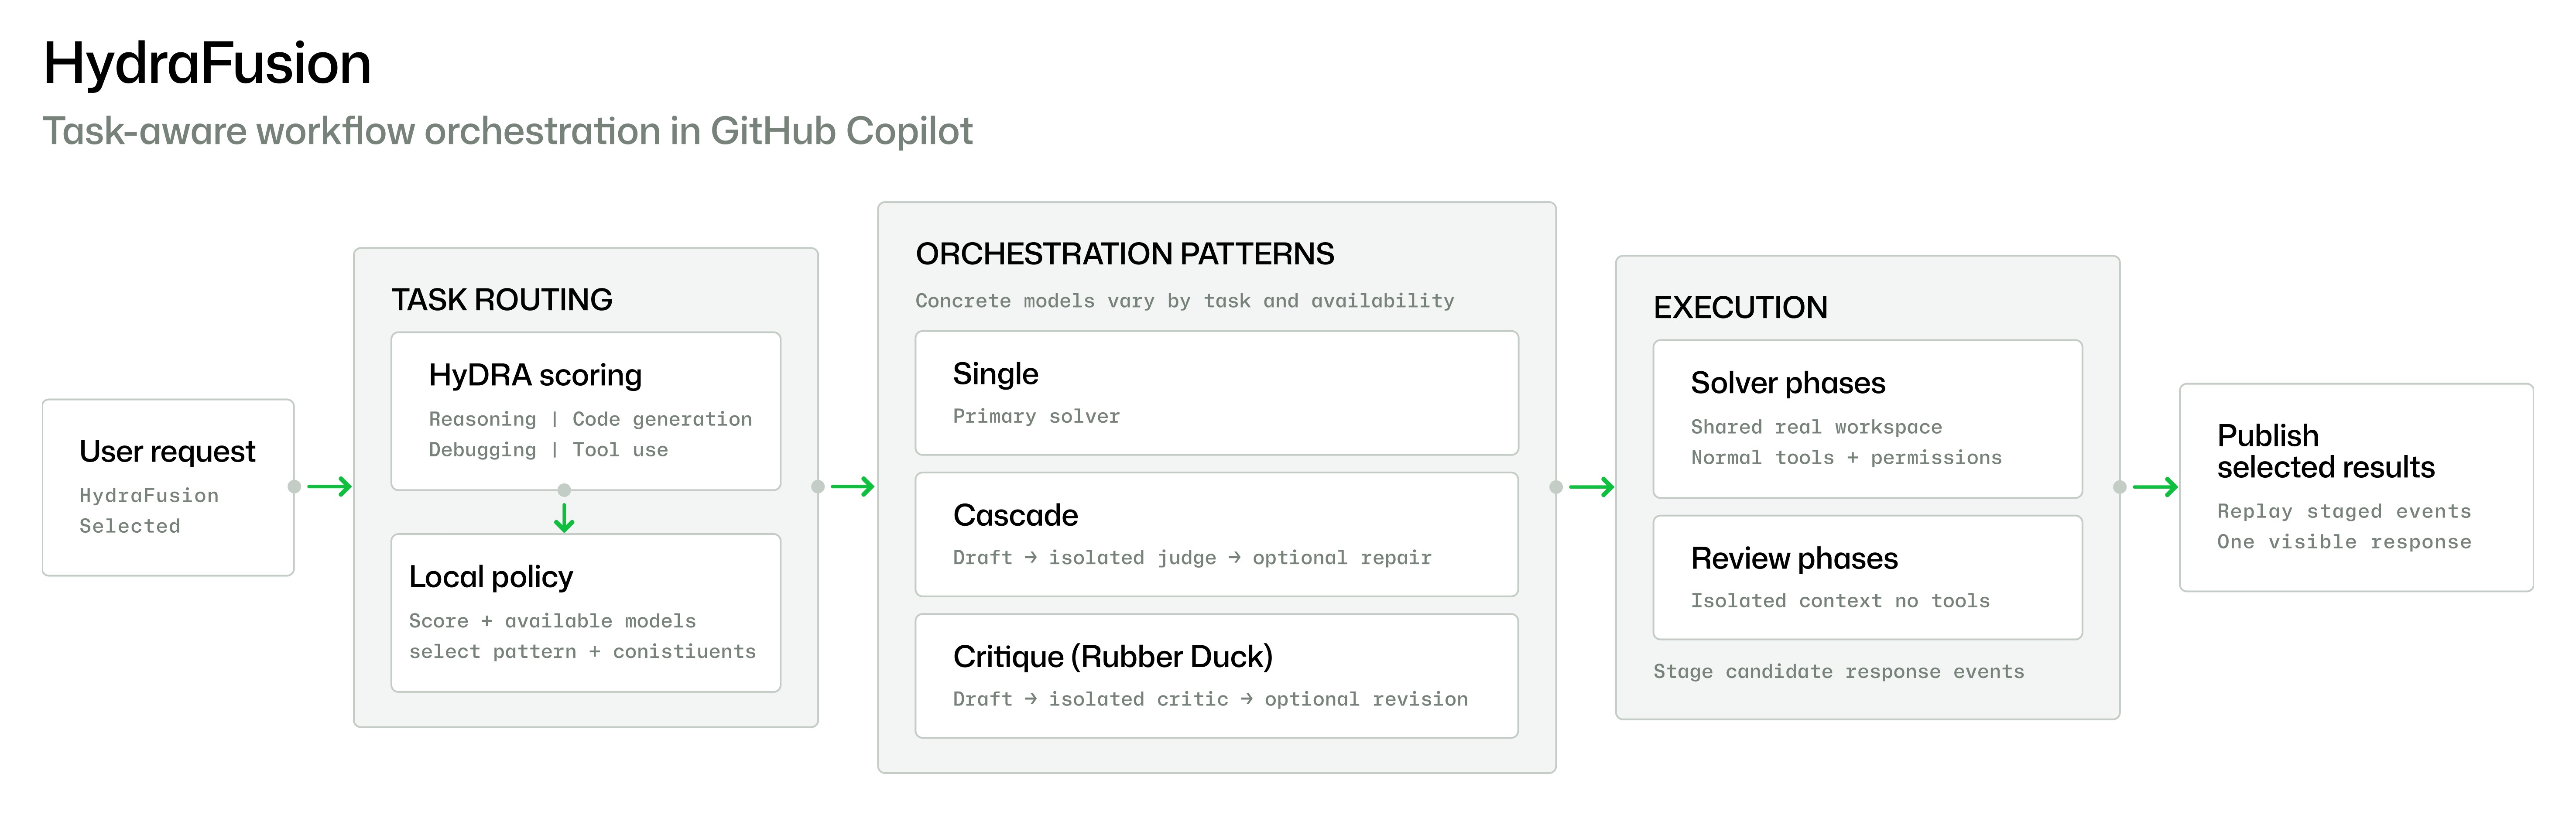
Le billet pose aussi cinq principes : comptabilité complète du coût de chaque étape, exécution bornée par des délais et une possibilité d’annulation, revue isolée (sans outils, sans modification du dépôt), application « fail-safe » qui n’applique aucun patch en cas d’annulation ou d’échec de validation, et routage validé avant l’exécution. Il n’existe pas de liste fixe de modèles : GitHub mêle modèles rapides et modèles plus forts en raisonnement, de plusieurs fournisseurs, et ce pool évolue.
## Benchmarks HydraFusion : trois tests, tous menés par GitHub
GitHub compare HydraFusion à Claude Opus 5 sur trois benchmarks agentiques, avec des coûts estimés qui incluent toutes les étapes (rédaction, critique, révision, escalade) :
| Benchmark | Coût estimé | Qualité |
| --- | --- | --- |
| TerminalBench 2.1 | **−67 %** | +4,9 points |
| DeepSWE | −36 % | −1,5 point |
| CheckpointBench (interne) | −65 % | −0,1 point |
Source : GitHub, résultats par rapport à Claude Opus 5.
Ces chiffres demandent de la prudence. Selon GitHub, ils correspondent à la « best tuned HydraFusion configuration », mesurée hors ligne avec tous les modèles au même niveau de raisonnement « medium », et restent propres aux versions de benchmarks, aux configurations, au pool de modèles et aux hypothèses de prix évalués. CheckpointBench est un benchmark interne, construit par GitHub à partir de vraies sessions Copilot, et l’entreprise reconnaît elle-même que TerminalBench 2.1 est relativement saturé. Sur DeepSWE, la qualité recule de 1,5 point. Nous n’avons trouvé aucun test indépendant qui reproduise ces mesures.
La facture réelle dépend aussi des règles de facturation : il n’y a pas de frais HydraFusion distincts, chaque modèle utilisé est facturé à son tarif standard, la remise d’Auto ne s’applique pas, et **une tâche peut consommer plus de crédits qu’avec un seul modèle**.
Les limites sont documentées :
- pas de sous-agents
- pas de SLA
- un service qui n’est pas destiné à la production
- et des modifications de fichiers qui ne sont pas annulées automatiquement lorsqu’un brouillon est écarté
GitHub conseille d’ailleurs de relire les changements avant de les valider (ce qu’on fait de moins en moins avec la qualité des derniers modèles). La première version vise d’abord les tâches de code à prompt unique, au premier tour.
## OpenRouter face à HydraFusion : Auto Router, fallbacks et Fusion
Précision d’abord : ce rapprochement est notre lecture, pas une affirmation de GitHub ou d’OpenRouter. Les deux ne sont pas comparables terme à terme : HydraFusion orchestre un workflow dans un outil de code, OpenRouter est une passerelle multi-fournisseurs dotée de routeurs.
| Outil | Rôle | Modèles par requête | Logique de choix | Coût annoncé |
| --- | --- | --- | --- | --- |
| **HydraFusion** (GitHub Copilot) | Orchestrateur de workflow | Un ou plusieurs, en séquence | Schéma Single, Cascade ou Critique choisi à chaque prompt ; porte de qualité ou critique isolé | Chaque modèle à son tarif standard, sans remise Auto ; peut dépasser le coût d’un seul modèle |
| OpenRouter **Auto Router** | Routeur de passerelle | Un seul | Type de tâche (environ 30), part de dépenses sur 7 jours, palier de coût | Aucun frais supplémentaire |
| OpenRouter **fallbacks** | Résilience | Un seul à la fois, le suivant en cas d’erreur | Liste ordonnée ; déclenchement sur erreur (contexte, modération, rate limit, indisponibilité) | Prix du modèle réellement utilisé |
| OpenRouter **Fusion** | Panel et juge | \1à 8, en parallèle | Le panel répond, un juge compare, le modèle appelant rédige | Environ 4 à 5 fois une complétion pour trois modèles, souvent 2 à 3 fois plus long |
Sources : GitHub, OpenRouter (documentations officielles) ; synthèse de l’auteur.
Chez OpenRouter, l’[Auto Router](https://www.openrouter.ai/docs/guides/routing/routers/auto-router.md) (openrouter/auto) ressemble à l’Auto de Copilot : il range le prompt dans l’un des quelque 30 types de tâche, classe les modèles selon la part de dépenses de la communauté sur sept jours glissants, applique un palier de coût et fait répondre un seul modèle, sans frais supplémentaires. Les [fallbacks](https://openrouter.ai/docs/guides/routing/model-fallbacks) jouent un autre rôle : si le premier modèle d’une liste renvoie une erreur (contexte trop long, modération, rate limiting, indisponibilité), le suivant prend le relais, facturé au prix du modèle réellement utilisé. Le déclencheur est l’erreur, et la documentation ne mentionne aucun critère de qualité sur la réponse.
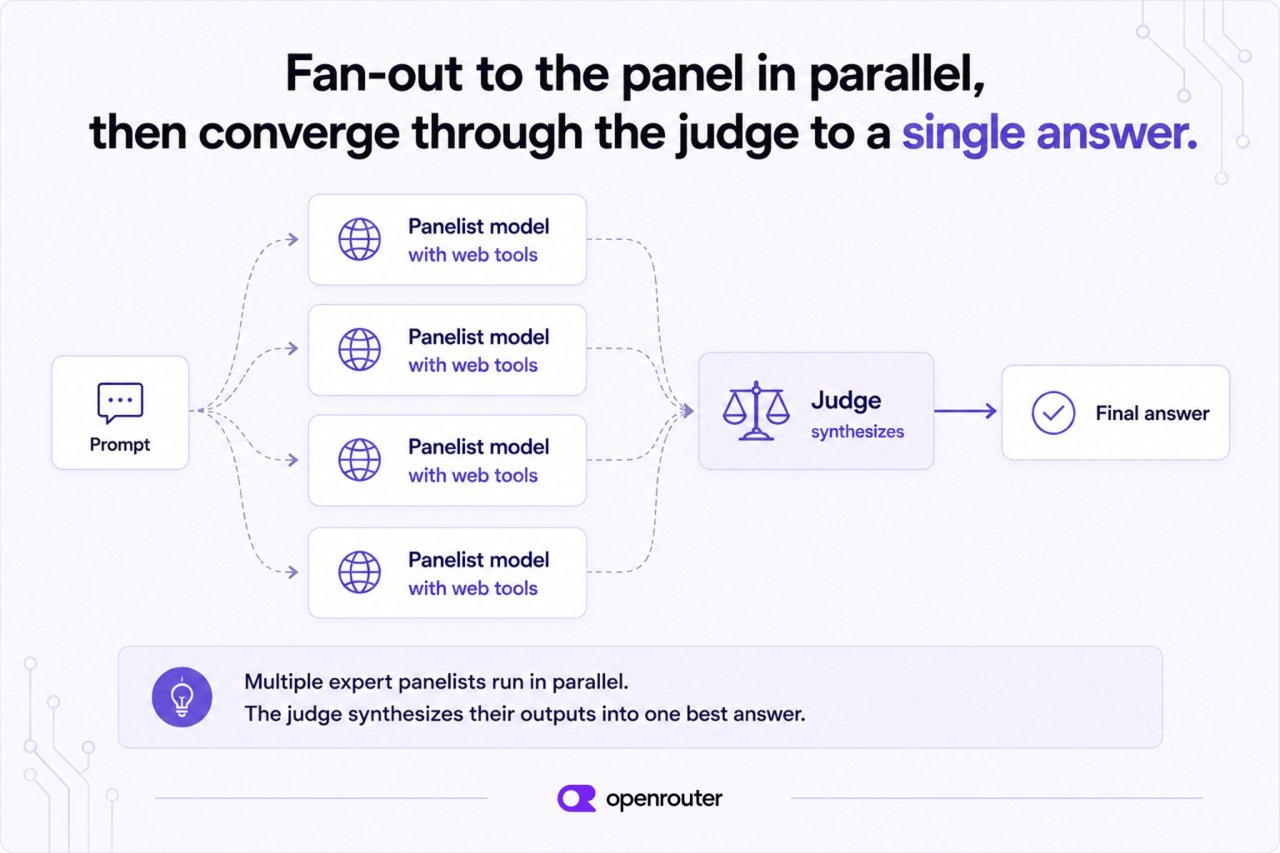
Fusion, lancé à la mi-juin 2026, va dans la direction inverse de la sobriété affichée par HydraFusion. Le prompt part en parallèle vers un panel de 1 à 8 modèles, un juge compare les réponses, puis le modèle appelant rédige la version finale. D’après l’[explicatif d’OpenRouter](https://openrouter.ai/blog/insights/fusion-explainer/), le panel par défaut de trois modèles coûte environ quatre à cinq fois plus qu’une complétion et prend souvent deux à trois fois plus de temps, et l’entreprise recommande l’escalade sélective. Ses résultats sur le benchmark DRACO, qui mesure la recherche approfondie et non le code, sont publiés par OpenRouter lui-même. En résumé, Fusion mise sur le fan-out parallèle, HydraFusion sur le moins de passes possible.
## HydraFusion : GitHub vise un routage entre modèles locaux, cloud et composés
GitHub écrit que HydraFusion « fills a key role in our overall strategy to deliver automated semantic routing between local, cloud, and compound models », une déclaration d’intention plus qu’une fonctionnalité documentée. Le billet ne détaille aucun modèle local utilisé par HydraFusion, ni aucune intégration avec OpenRouter.
Reste à savoir si ces économies annoncées résistent à un test indépendant, et si la facture tient quand chaque étape d’une cascade est facturée à son tarif standard.
---
**Article précédent:** [Anthropic interdit la cruauté envers Claude, l'IA est-elle consciente ?](https://pix-geeks.com/anthropic-interdit-cruaute-envers-claude-ia-consciente/)