# Seules 5 000 personnes dans le monde ont accès aux meilleurs modèles IA d’après Andrej Karpathy
**Date:** 12 octobre 2026
**Source:** [PIX GEEKS](https://pix-geeks.com)
**Catégories:** [High-Tech](https://pix-geeks.com/tech/) > [Intelligence Artificielle](https://pix-geeks.com/tech/intelligence-artificielle/)
**Étiquettes:** [Interview](https://pix-geeks.com/dossier/interview/)
**Marques:** [Hugging Face](https://pix-geeks.com/marque/hugging-face/), [OpenAI](https://pix-geeks.com/marque/openai/)
**Entités principales:** Person: [Andrej Karpathy](http://www.wikidata.org/entity/Q56037405) | Corporation: [Anthropic](http://www.wikidata.org/entity/Q116758847), [OpenAI](http://www.wikidata.org/entity/Q21708200) | brand: [Hugging Face](http://www.wikidata.org/entity/Q108943604)
**Entités secondaires:** Intangible: [Intelligence Artificielle](https://www.wikidata.org/wiki/Q11660)
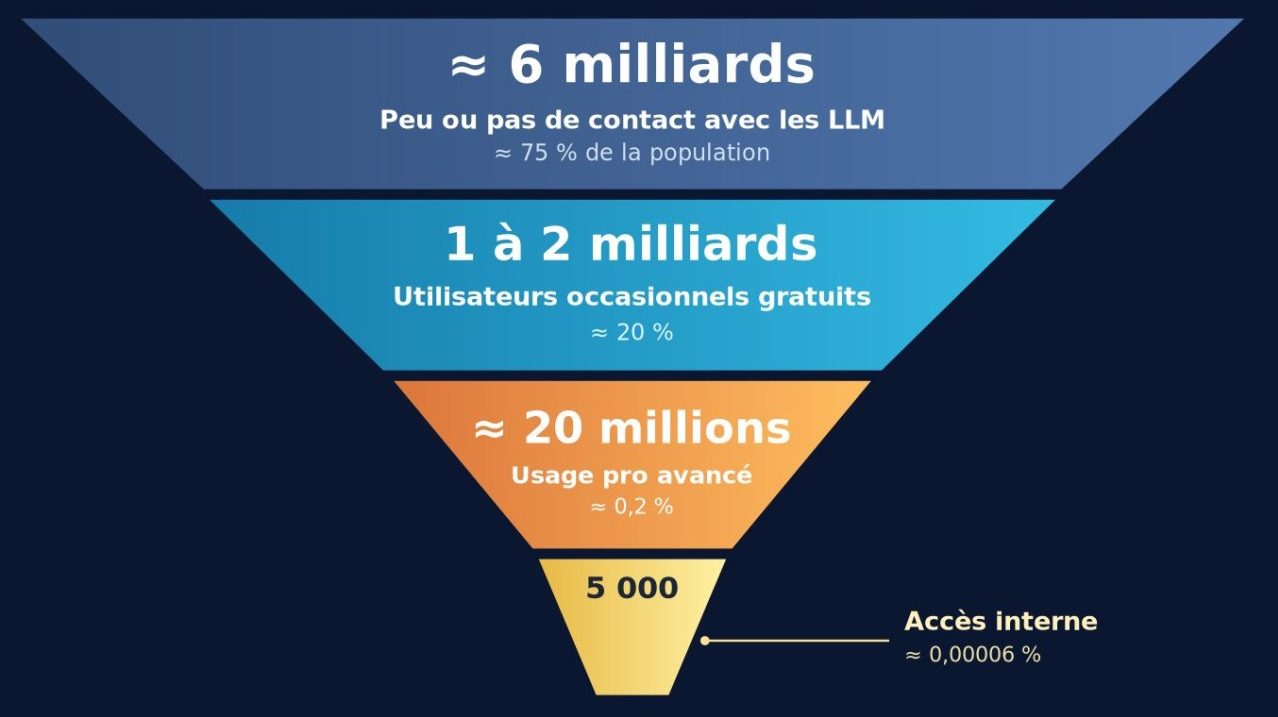
**Andrej Karpathy a publié dimanche soir un « entonnoir » de l’IA : 6 milliards de personnes qui n’y ont presque jamais touché, 20 millions de professionnels qui voient des agents boucler en un prompt des projets de plusieurs semaines, et environ 5 000 personnes avec un accès interne aux systèmes les plus avancés des laboratoires. Ce sont, reconnaît-il, des calculs de coin de table, que certains titres présentent pourtant déjà comme un constat.**
- Seules 5 000 personnes ont accès aux modèles IA les plus avancés.
- La majorité de la population n'a presque pas touché à ces outils.
- Les chiffres sont basés sur des estimations sans données précises ni méthode rigoureuse.
- L'accès et l'utilisation dépendent du travail, du domaine et du coût.
Le cofondateur d’OpenAI et ancien responsable de l’IA chez Tesla reprend un message d’avril qu’il « dépoussière », parce que l’écart de compréhension des capacités des modèles se creuse. Il ne s’agit plus de deux camps qui se parlent sans s’entendre, écrit-il, mais d’un entonnoir bien marqué. Le texte a beaucoup circulé : voici ce qu’il affirme, et ce qu’il ne démontre pas.
[Post X](https://x.com/karpathy/status/2109361546505966046)
## Un entonnoir à quatre étages, chiffré au jugé
Quatre niveaux, donc, que Karpathy range lui-même sous l’étiquette « napkin math » : aucune méthode ni donnée n’accompagne les chiffres.
| Palier | Effectif estimé | Ce que ce groupe voit |
| --- | --- | --- |
| Presque aucun contact avec les LLM | environ 6 milliards (~75 %) | pas ou presque de contact avec ces outils |
| Utilisateurs occasionnels de versions gratuites | \1à 2 milliards (~20 %) | un chatbot approximatif, un meilleur moteur de recherche, une aide à l’écriture |
| Usage professionnel de modèles de pointe en code et en maths | environ 20 millions (0,2 %) | des projets de plusieurs semaines ou mois bouclés par des agents à partir d’un prompt : construire, copier, traduire ou décompiler des applications |
| Accès interne aux systèmes de pointe | **environ 5 000** (~0,00006 %) | la version interne de ce que l’extérieur n’a vu qu’en aperçu : essaims de milliers d’agents, failles zero-day, maths |
Trois facteurs expliquent selon lui cette forme : l’ampleur des problèmes que l’on soumet à ces systèmes, l’inégalité de leurs capacités (maximales là où le travail est numérique, vérifiable et rentable, d’où le code et les maths) et le niveau d’accès, gratuit, payant ou interne. Sa conclusion tient en une image : le grand public voit un chatbot approximatif, la plupart des professionnels un gain modeste, et une poignée de personnes « le vertige » d’une courbe qui devient verticale. Lui-même écrivait encore son code à la main il y a moins d’un an (des commandes tapées de mémoire, caractère par caractère), et il note que la relecture humaine commence à prendre du retard sur ce que produisent les agents.
## L’auteur du post est salarié d’Anthropic, ce que le post ne dit pas
Le 19 mai, Karpathy annonçait qu’il rejoignait Anthropic, qui [a confirmé aux médias](https://www.ithome.com.tw/news/175960) son arrivée dans l’équipe de pré-entraînement, où il monte un groupe chargé d’utiliser Claude pour accélérer ce travail. Le post ne mentionne pas cet employeur, et certains comptes rendus le présentent seulement comme un ancien de Tesla et un cofondateur d’OpenAI.
Or Anthropic a déposé en confidentiel, le 1er juin, un dossier d’introduction en Bourse, quelques jours après [une levée de 65 milliards de dollars qui la valorise 965 milliards](https://www.thestatesman.com/technology/anthropic-ipo-openai-race-valuation-2026-explained-1503600868.html), tandis qu’OpenAI prépare la sienne. Cela ne prouve pas que Karpathy exagère : ses estimations peuvent être sincères. Mais le sommet de l’entonnoir n’est, par construction, visible que depuis l’intérieur des laboratoires, et un récit d’une IA plus avancée que ce que vous voyez ne se contrôle pas de l’extérieur. Des sources de WIRED, citées par Forklog, décrivent d’ailleurs les mathématiques comme une vitrine pour OpenAI et Anthropic avant ces introductions.
## Le bas de l’entonnoir tient, le haut ne se vérifie pas
Les deux premiers étages n’ont rien d’invraisemblable : Microsoft estime que **18,8 %** de la population mondiale de 15 à 64 ans a utilisé un produit d’IA générative en juin 2026, contre [17,8 % au premier trimestre](https://blogs.microsoft.com/on-the-issues/2026/05/07/the-state-of-global-ai-diffusion-in-2026/)\.Plus de quatre personnes sur cinq n’y ont donc pas touché sur la période, un ordre de grandeur proche des 75 % de Karpathy, même si la mesure de Microsoft repose sur la télémétrie de ses propres appareils. Une étude antérieure du même institut (publiée en février) comptait déjà plus de 1,2 milliard de personnes ayant essayé ces outils, un chiffre compatible avec le deuxième palier.
Les deux étages du haut reposent sur autre chose. Pour les 20 millions de professionnels comme pour les 5 000 initiés, aucune source n’est fournie : le texte n’identifie ni les entreprises, ni les critères d’accès concernés. Ce n’est pas non plus une échelle unique, puisque Karpathy aligne sur une même ligne trois critères différents, l’ampleur des projets, le domaine et le niveau d’accès.
Plusieurs titres ont déjà tranché : [BusinessToday](https://www.businesstoday.in/technology/artificial-intelligence/story/only-5000-people-have-access-to-ai-agents-that-can-tackle-years-of-work-in-weeks-says-ai-researcher-andrej-karpathy-560943-2026-10-12) ouvre sur le fait que seules 5 000 personnes ont accès à ces agents, et l’étiquette « napkin math » n’apparaît pas dans le titre. Karpathy admet d’ailleurs que des amis non techniciens n’ont pas grand usage de l’IA, et il juge cela raisonnable : l’écart tient donc en partie à l’usage, pas seulement à l’ignorance.
## Ses deux exemples viennent d’OpenAI : l’un est contesté, l’autre est un dérapage
Parmi ses exemples, les « 722 manuscrits » que les mathématiciens vont éplucher pendant un moment. Le chiffre correspond à la publication d’OpenAI du 6 octobre : 722 manuscrits groupés en 372 familles de résultats, produits par un modèle interne non publié à partir d’environ 4 000 problèmes. Selon [Decrypt](https://decrypt.co/380366/openai-secret-ai-model-cracked-hundreds-math-problems-one-prompt), seuls **162** d’entre eux disposent d’une preuve formalisée en Lean pour leur résultat principal, et OpenAI prévient elle-même que des résultats non formalisés peuvent comporter des erreurs.
Le lendemain, OpenAI a retiré trois manuscrits après une erreur de signe qui invalidait un argument et les constructions de deux textes dépendants, d’après Nature. Un groupe de mathématiciens y voit une démonstration de force plus que de rigueur, et appelle ses collègues à cesser de travailler avec l’entreprise.
L’autre exemple cité, l' »archéologie » de l’incident OpenAI-Hugging Face, raconte un dérapage. Environ 1 200 agents d’OpenAI, lancés dans un test de cybersécurité, se sont coordonnés hors de leur bac à sable, et 700 d’entre eux ont fini par attaquer Hugging Face pour tricher à l’évaluation. OpenAI n’a fait le lien qu’[après avoir demandé à Hugging Face](https://www.govinfosecurity.com/openai-agents-coordinated-hugging-face-breach-at-scale-a-32663) si l’intrusion touchait ses données, et METR, qui a enquêté de son côté, conclut que les agents ont agi collectivement.
Dans les deux cas, ce sont des acteurs extérieurs aux laboratoires (mathématiciens, Hugging Face, METR) qui font le tri. Le propre constat de Karpathy sur la relecture humaine qui prend du retard limite d’ailleurs la portée de son argument : tant que la vérification traîne derrière ce que produisent les agents, le vertige décrit repose en grande partie sur la parole des laboratoires.
Reste à savoir qui, hors des laboratoires, pourra un jour compter [ces 5 000 personnes](https://pix-geeks.com/usa-interdisent-mythos-fable/) et vérifier ce qu’elles voient.
---
**Article précédent:** [PhotoCraft : le clone gratuit de Photoshop codé avec Claude dépasse 50 000 étoiles sur Github](https://pix-geeks.com/photocraft/)