# Jev, l’IA qui ne sait pas écrire : un « TensorFlow sous stéroïdes » sans entraînement
**Date:** 19 octobre 2026
**Source:** [PIX GEEKS](https://pix-geeks.com)
**Catégories:** [High-Tech](https://pix-geeks.com/tech/) > [Intelligence Artificielle](https://pix-geeks.com/tech/intelligence-artificielle/)
**Étiquettes:** [JEV](https://pix-geeks.com/dossier/jev/)
**Entités principales:** SoftwareApplication: [Jev](http://www.wikidata.org/entity/Q1632450) | Organization: [TypeSafe](http://www.wikidata.org/entity/Q7860966) | Person: [Jack & Jill](http://www.wikidata.org/entity/Q1159009)
**Entités secondaires:** SoftwareApplication: [Jev Jev](http://www.wikidata.org/entity/Q135011969) | Person: [Diogo Almeida](http://www.wikidata.org/entity/Q119084861), [Daniel Kahneman](http://www.wikidata.org/entity/Q233950) | Organization: [TechCrunch](http://www.wikidata.org/entity/Q1022366) | Intangible: [Intelligence Artificielle](https://www.wikidata.org/wiki/Q11660)
**Jev ne sait pas écrire une phrase. Le premier modèle de TypeSafe AI, lancé le 15 septembre, choisit parmi des réponses que vous définissez vous-même, avec une probabilité, en quelques centaines de millisecondes. Un classifieur à l’ancienne, mais sans jeu de données à étiqueter ni entraînement, et déjà adopté à une vitesse record.**
Pour apprendre à un modèle TensorFlow à distinguer une critique de film positive d’une critique négative, le [tutoriel officiel de Google](https://www.tensorflow.org/tutorials/keras/text_classification) commence par télécharger 50 000 critiques du site IMDB. Viennent ensuite la préparation des données, l’entraînement et la validation. Et le jour où vous voulez une troisième catégorie, il faut réentraîner, parce que ce type de classifieur reste figé sur les classes vues à l’entraînement.
Jev prend le problème à l’envers. Vous lui envoyez un texte ou un objet JSON et vous décrivez dans la même requête les réponses possibles (« facturation », « technique », « commercial »). Le modèle choisit une case et renvoie une probabilité pour chacune, sans avoir jamais vu vos données.
Un chatbot ? Non. Un classifieur maison ? Pas davantage. Jev est un classifieur généraliste, que l’on reconfigure à chaque appel et qui, selon TypeSafe, approche l’intelligence des grands modèles sur ce type de tâche.
## Jev de TypeSafe AI : un classifieur sans entraînement, les classes dans la requête
TypeSafe AI, la start-up derrière Jev, est fondée par Diogo Almeida, un ancien chercheur d’OpenAI qui a contribué à la méthode d’apprentissage RLHF et à ChatGPT. Dans son [billet de lancement](https://typesafe.ai/blog/introducing-system-one-models-and-jev), il présente Jev comme un appel de fonction doté d’une intelligence de pointe : un état non structuré en entrée, des décisions typées et probabilistes en sortie. La société est sortie de deux ans de discrétion avec une levée de 40 millions de dollars menée par DCVC. Elle appelle cette famille les modèles « System One », en clin d’œil à la pensée rapide et intuitive décrite par Daniel Kahneman dans Système 1 / Système 2.
Concrètement, le développeur dispose de trois types de questions. Choice choisit une option dans une liste, jusqu’à 255 options par question. Score place l’entrée sur une échelle ordonnée, et Noul répond par oui ou non, sous forme de probabilité. Pour un ticket client à router vers trois services, Jev peut ainsi renvoyer 85 % pour le service technique, 8 % pour la facturation et 7 % pour le commercial, avec un indice de confiance global de 0,82.
Avec un classifieur entraîné sous TensorFlow, les catégories sont gravées dans le modèle. Avec Jev, elles vivent dans votre code, si bien qu’ajouter une classe « autre » ou découper « technique » en deux ne demande ni nouveau jeu de données ni réentraînement. Le revers est net, en revanche : Jev ne fournit aucune justification, seulement des chiffres.
## Prix de Jev : 0,042 $ le million de tokens et 70 à 500 ms par réponse
Le prix est l’argument qui a fait parler. TypeSafe facture **0,042 dollar le million de tokens en entrée**, soit 42 dollars le milliard, et la sortie est gratuite. La société annonce une réponse en 70 à 500 millisecondes, car Jev calcule toutes ses réponses en parallèle au lieu de générer du texte mot après mot. Sur la démonstration de son site, Jev boucle la tâche en 0,114 seconde, quand un modèle GPT-5.6 d’OpenAI met 8,566 secondes.
TypeSafe va plus loin et affiche des gains de 193,6 fois en vitesse et de 444,6 fois en coût. Ces chiffres sont à lire avec les réserves que l’entreprise publie elle-même. Ils viennent de quatre workflows conçus par sa propre équipe et mesurés contre la moyenne de deux modèles haut de gamme, et TypeSafe les situe dans le haut de la fourchette des gains réels. La start-up reconnaît même qu’elle ne peut pas prouver que son tarif n’est pas subventionné.
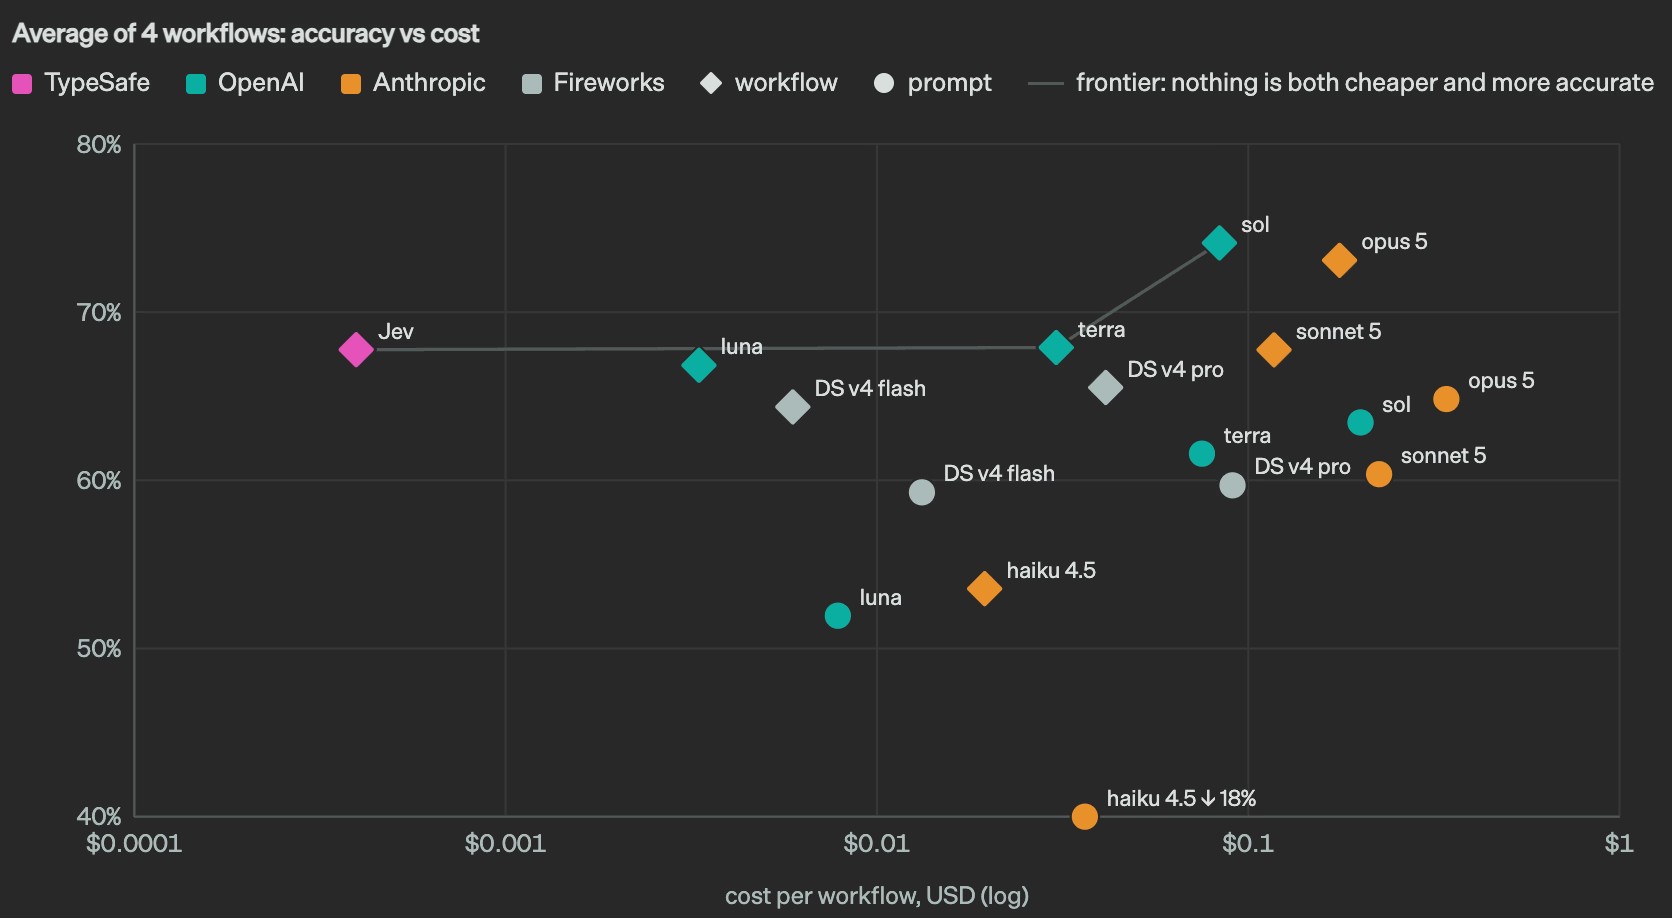
Source : TypeSafe AI (moyenne de 4 workflows, coût en échelle logarithmique)
Le graphique de TypeSafe résume le pari. Jev n’est pas le plus précis du lot, mais il approche des modèles bien plus chers pour un coût par workflow nettement plus bas, au moins sur les mesures de l’entreprise.
## Jev en pratique : 6 exemples concrets d’application
### Trier 6 000 candidats par poste chez Jack & Jill
Le cas le plus détaillé est celui de Jack & Jill, une plateforme de recrutement où des agents IA mettent en relation candidats et entreprises. Chaque jour, 6 000 profils par poste ouvert passent par une première étape de notation. Selon [l’étude de cas publiée par TypeSafe](https://typesafe.ai/blog/jack-jill-jev-case-study), Jev a remplacé Gemini 3.1 Flash Lite sur 100 % de ces appels, dix jours après le premier test.
| Mesure | Gemini 3.1 Flash Lite | Jev |
| --- | --- | --- |
| Coût pour 1 000 candidats notés | 0,755 $ | 0,092 $ |
| Temps médian par poste | 20,3 s | 10,3 s |
| Candidats ensuite demandés par les recruteurs, conservés dans la présélection | 93,9 % | 94,6 % |
Source : [TypeSafe AI, étude de cas Jack & Jill](https://typesafe.ai/blog/jack-jill-jev-case-study)
Le coût baisse de **88 %** pour une qualité équivalente (l’écart de 0,7 point en faveur de Jev n’est pas statistiquement significatif, admet l’étude). Jack & Jill projette 500 000 dollars d’économies sur douze mois, dont 265 000 au volume actuel, et fait désormais tourner Jev dans plus de quinze workflows.
### Filtrer les commandes dangereuses d’un agent chez Vercel
Vercel, qui fournit de l’infrastructure pour les agents IA, utilisait un modèle Luna d’OpenAI pour vérifier si une commande était sûre avant de l’exécuter. Après le passage à Jev, l’entreprise a obtenu des résultats 5 à 18 fois plus rapides et plus précis, a indiqué l’ingénieur Pranit Sharma, cité par [TechCrunch](https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/).
[Post X](https://x.com/fazxes/status/2100300097695232164)
### Router tickets, e-mails et modèles d’IA
Le routage est l’usage le plus naturel. Nikhil Mudholkar, directeur technique de Bryo AI, a comparé Jev à Gemini pour classer des e-mails professionnels : Gemini était légèrement plus précis, mais 10 à 20 fois plus cher. Lui retient surtout les probabilités renvoyées, qui rendent selon lui Jev idéal pour automatiser des workflows.
Armin Ronacher, directeur technique d’Earendil, voit aussi Jev en aiguilleur chargé de décider en temps réel quel modèle d’IA doit traiter une requête, un travail trop coûteux à confier à un LLM classique.
### Classer des formulaires fiscaux de l’IRS à la chaîne
Un projet baptisé tax-doc-classifier, décrit dans une étude publiée sur arXiv, utilise Jev pour identifier chaque page de documents fiscaux américains : le formulaire de l’IRS concerné et le type de page. Le [programme](https://pix-geeks.com/programme-tv/) fixe lui-même un seuil de confiance : au-dessus, la page part en traitement automatique, en dessous elle est mise de côté. Ce partage des rôles (la probabilité pour Jev, la décision finale pour le code) est précisément le mode d’emploi que vante TypeSafe, qui laisse au développeur le soin de fixer ses seuils.
### Jouer à Doom avec 10 décisions par seconde
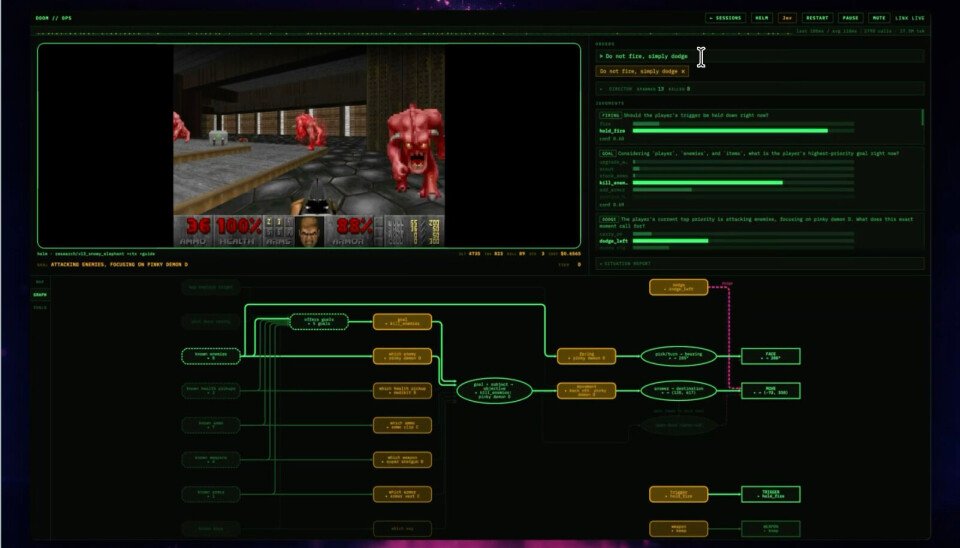
La démonstration la plus spectaculaire de TypeSafe est un bot qui joue à Doom en interrogeant Jev dix fois par seconde, pour environ 7 dollars de l’heure. Le jeu ne lui est pas montré en images, le bot reçoit une description textuelle de l’état de la partie. TypeSafe reconnaît d’ailleurs qu’un bot sans IA jouerait mieux. Peu importe : la démonstration montre ce que permet une décision à moins d’une demi-seconde dans une application en temps réel.
### Classer les articles et construire le maillage interne : mon usage de Jev
J’utilise moi-même Jev sur mes sites WordPress, pour deux tâches qui consomment habituellement un temps fou. La première est la classification automatique des articles : chaque texte est envoyé à Jev avec la liste des catégories du site, et une question Choice désigne celle qui lui correspond, avec une probabilité. Quand la confiance est faible, l’article n’est pas rangé automatiquement, il attend une validation à la main.
La seconde est l’optimisation du maillage interne sémantique. Plutôt que de lier des pages parce qu’elles partagent un mot-clé, je demande à Jev si deux articles traitent réellement du même sujet (une question oui/non, sous forme de probabilité), puis je ne garde que les liens les plus pertinents. C’est exactement le type de jugement « flou » qu’un if ne sait pas écrire, et qui coûtait trop cher à confier à un chatbot article par article.
## Jev adopté par 35 % des équipes payantes de la passerelle IA de Vercel
L’engouement s’est vite traduit dans les chiffres. Deux semaines après son lancement, Jev était utilisé par **35 % des équipes payantes** passant par la passerelle IA de Vercel, près du double du deuxième modèle, Sonnet 5.5, selon des données de Vercel rapportées par TechCrunch. La mesure ne couvre qu’une passerelle et sous-estime les grands laboratoires qui vendent leurs propres API, mais aucun modèle n’avait été adopté aussi vite sur cette plateforme. OpenAI et Amazon ont depuis lancé leurs propres modèles de décision.
Combien vaut vraiment Jev face à ses concurrents ? Un banc d’essai indépendant publié le 10 octobre par Fabio Akita sur son blog Akita On Rails donne un ordre de grandeur. Sur ses cas de test courts, en anglais et en portugais, [Jev atteint 97,6 % de bonnes réponses](https://akitaonrails.com/en/2026/10/10/which-jev-like-ai-decision-classifier-model-is-best/), avec une latence médiane de 255 millisecondes et un coût de 0,19 dollar pour 10 000 décisions. Microsoft Decision-1 fait jeu égal pour un tiers du prix, et deux modèles ouverts montent à 99,4 %, au prix d’environ 49 Go de poids et de plus d’une seconde par décision sur sa machine. L’auteur prévient que son jeu de test, synthétique, reste petit.
## Les limites de Jev : « sans hallucination » ne veut pas dire sans erreur
TypeSafe répète que Jev « ne peut pas halluciner ». La promesse est exacte mais étroite, puisque Jev ne peut jamais répondre en dehors des cases prévues… ce qui ne l’empêche pas de choisir la mauvaise. La documentation relayée par l’outil d’évaluation Promptfoo liste d’autres limites de la version 1.13 : Jev est peu fiable en arithmétique, en comptage et en comparaison de dates (une version 1.14, en préversion depuis le 14 octobre, promet surtout un meilleur support multilingue). Ses probabilités sont aussi relatives aux options fournies, si bien qu’une catégorie peut obtenir un score élevé même quand aucune ne convient, d’où le conseil d’ajouter une case « autre ».
La sécurité est l’autre point sensible. La société HiddenLayer affirme que Jev peut être trompé par injection de prompt et par des textes légèrement altérés, une technique qui, selon elle, fonctionne mal sur les grands LLM, [rapporte InfoWorld](https://www.infoworld.com/article/4236103/typesafes-jev-even-more-susceptible-to-attack-than-llms-says-security-vendor.html)\.Aucun taux de réussite n’a été publié et TypeSafe n’a pas répondu, tandis qu’un analyste de Gartner juge le modèle trop récent pour être évalué équitablement. Le conseil de HiddenLayer, lui, est simple : tester Jev dans l’application réelle et garder des contrôles indépendants sur les décisions qui comptent.
Fabio Akita, lui, ramène l’engouement à sa juste mesure. Jev est un classifieur, une technologie qui existe depuis des décennies, et l’effet « 193 fois plus rapide » vient surtout de ce que beaucoup utilisaient des chatbots comme classifieurs lents et coûteux. Un seuil numérique doit donc rester dans le code, sous la forme d’un simple if, et le modèle n’intervenir que pour transformer du texte libre en information exploitable.
Jev ne remplace pas ChatGPT : il ne sait pas écrire. Pour trier, router et vérifier à la chaîne, en revanche, il change l’équation économique, du moins sur les chiffres publiés jusqu’ici. Reste à savoir si le tarif de 0,042 dollar le million de tokens survivra à la ruée…
---
**Article précédent:** [Timestral : j'ai testé l'IA de Mistral qui prédit vos chiffres sans GPU](https://pix-geeks.com/timestral/)