Des chercheurs de Stanford et de Together AI présentent NCM, une IA qui écrit d’abord l’ossature d’un texte avant d’en remplir les détails. Elle va jusqu’à 31 fois plus vite que les modèles rivaux testés. Mais ce rival n’est pas ChatGPT, et le modèle reste un petit prototype de laboratoire.
- NCM est une IA de Stanford qui écrit rapidement en générant d'abord une structure, puis en remplissant les détails.
- Elle est jusqu’à 31 fois plus rapide que certains modèles de diffusion pour des tâches comme le résumé ou la traduction.
- Le modèle reste un prototype limité, avec environ 100 millions de paramètres et des performances inférieures à celles des grands modèles actuels.
D’abord une phrase anglaise qui ne veut rien dire, « However, it is a important to the the and the. », puis, onze étapes plus tard, une traduction propre. Voilà comment travaille NCM, pour « Next-Concept Modeling », un système décrit dans un article de recherche publié le 9 octobre 2026 par l’équipe Hazy Research de Christopher Ré, à Stanford, avec Simran Arora, de Together AI. Code et modèles sont publiés en open source, sous licence MIT.
Les chiffres ont vite circulé, et avec eux une idée fausse, celle d’une IA plus rapide que les grands modèles de langage, voire prête à les enterrer. Le papier ne dit pourtant rien de tel. Ses gains de vitesse sont mesurés face à une autre famille d’IA, les modèles de diffusion, et jamais face à ChatGPT, Claude ou Mistral. Alors, que vaut vraiment cette nouvelle façon d’écrire ?
LLM, diffusion, NCM : trois façons pour une IA d’écrire un texte
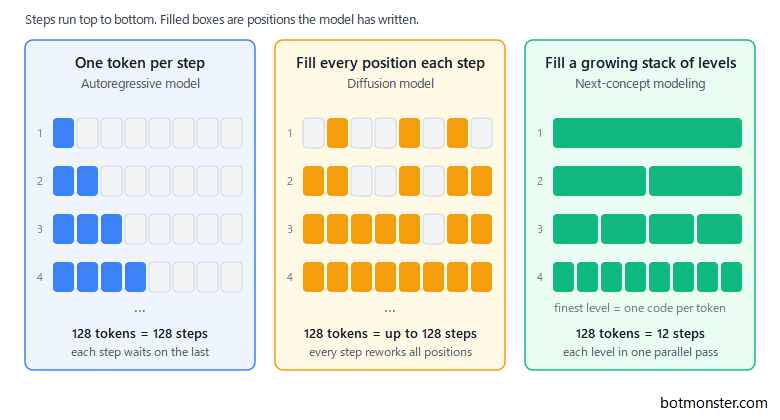
Un LLM classique écrit comme on dicte, un mot (ou un morceau de mot) à la fois, et chaque mot attend le précédent. Pour une réponse de 1 000 morceaux de mots, il faut donc 1 000 étapes, l’une après l’autre.
Les modèles de diffusion contournent ce goulot parce qu’ils travaillent sur toutes les positions en même temps : ils partent d’une page remplie de jetons aléatoires et la corrigent en plusieurs passes. Google en a sorti un en juin, DiffusionGemma, un modèle ouvert de 26 milliards de paramètres jusqu’à 4 fois plus rapide qu’un modèle classique sur GPU. Google reconnaît en revanche une qualité inférieure à celle de Gemma 4. Les chercheurs de Stanford reprochent d’ailleurs à cette famille de modèles de retraiter toute la séquence à chaque passe et de perdre en qualité dès qu’on réduit le nombre de passes.
NCM prend une troisième voie. Le texte est d’abord compressé en une pyramide de codes, avec quelques codes au sommet pour l’idée générale et de plus en plus en descendant pour les détails. Le modèle génère ensuite cette pyramide étage par étage, tous les codes d’un même étage d’un coup. Les chercheurs appellent « concept » l’information portée par les étages du haut, et l’idée vient de la génération d’images, où certains modèles dessinent une vignette floue avant de l’affiner.
Sur l’exemple de traduction du papier, le sujet de la phrase est en place dès le sixième étage, même si les mots bégaient encore. Au onzième et dernier, la traduction colle presque mot pour mot à la référence humaine.
NCM va 10 à 31 fois plus vite que les modèles de diffusion
Le gain vient de deux choses : moins de passes, et des passes moins coûteuses, puisque les premiers étages ne contiennent que quelques codes. Sur un test de génération de phrases baptisé LM1B, NCM utilise 12 passes contre 128 pour DUO, le meilleur modèle de diffusion comparé, produit un texte jugé plus naturel et tourne 21 fois plus vite. Sur le résumé d’articles, il égale le meilleur rival en 8 passes au lieu de 128 et en 31 fois moins de temps.
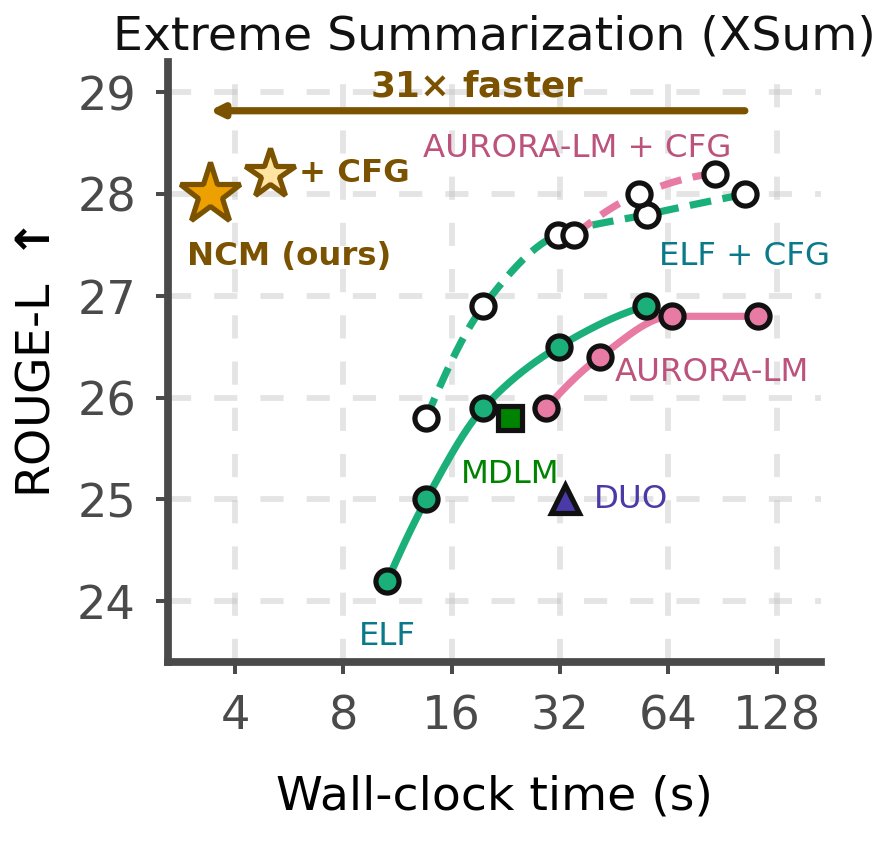
La victoire n’est pas totale : sur du texte web, NCM va 10 fois plus vite que la meilleure diffusion testée sans la dépasser, DUO y gardant un texte jugé plus naturel, et toutes les mesures ont été faites sur une seule carte Nvidia H100.
Côté entraînement, NCM a lu 4 à 5 fois moins de texte que ses rivaux. Les auteurs prennent soin de préciser qu’il s’agit d’un volume de données vues, pas d’une puissance de calcul. Si vous cherchez un prix ou une facture en euros, le papier n’en donne aucun.
NCM contre un LLM classique : gagnant au Sudoku, battu en traduction
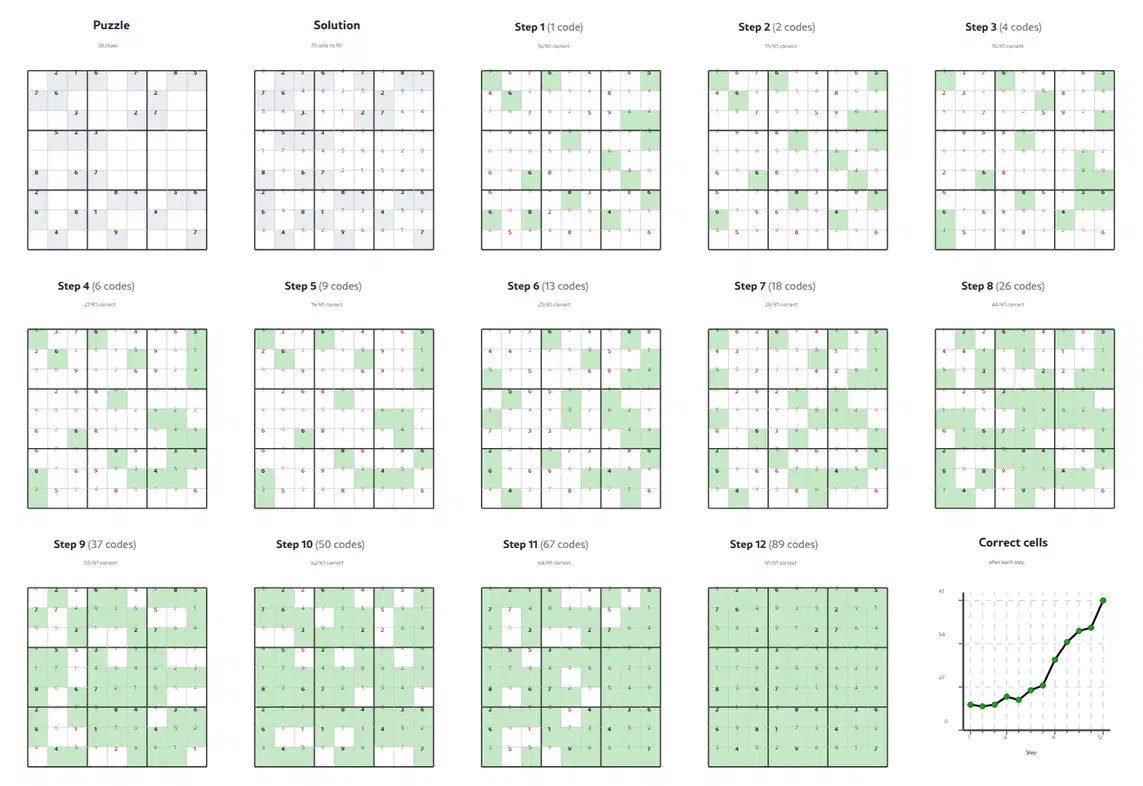
Le papier compare aussi NCM à un petit modèle classique de même taille, autour de 100 millions de paramètres. En résumé, NCM fait mieux, en 8 passes au lieu de 64. Au Sudoku, l’écart devient spectaculaire, avec 86,1 % des grilles difficiles résolues contre 1 % au mieux pour le modèle classique, parce que ce dernier ne peut jamais revenir sur un chiffre déjà posé alors que NCM retravaille la grille entière à chaque étage.
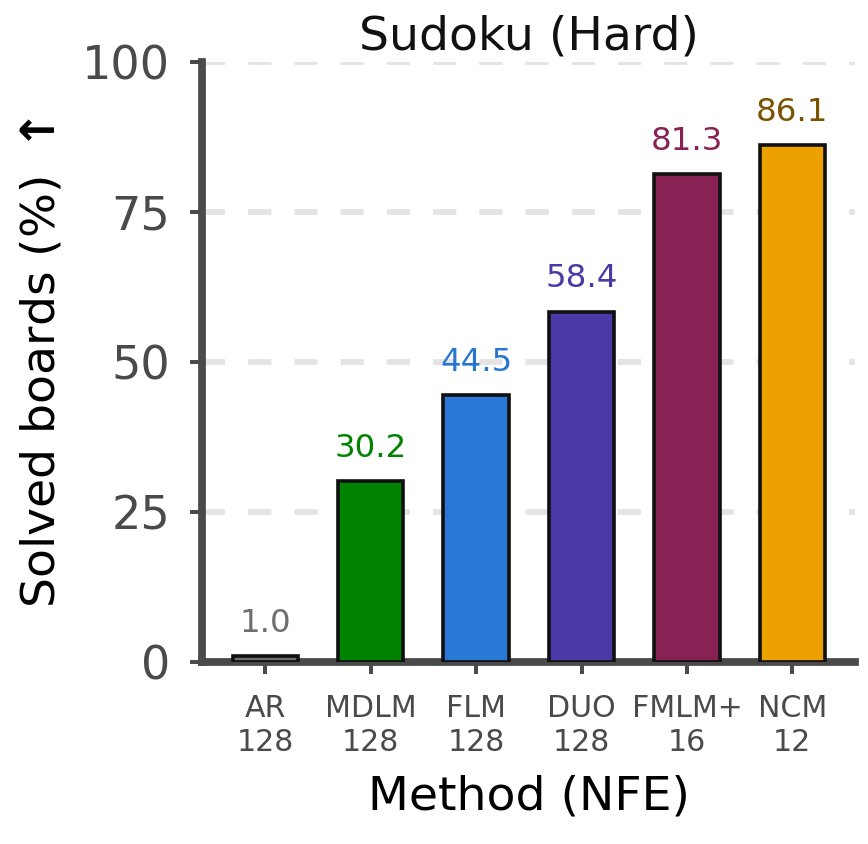
En traduction, le modèle classique reste pourtant devant, avec 25,2 points contre 22,6 au score BLEU. NCM ne l’égale qu’en écrivant 12 brouillons et en gardant le meilleur, ce qui lui coûte davantage de passes que son rival. Surtout, aucune comparaison de vitesse n’est publiée face aux modèles classiques, ni face au décodage spéculatif, l’astuce qui accélère déjà les LLM classiques.
NCM reste un prototype d’environ 100 millions de paramètres, loin de ChatGPT
L’échelle reste la principale limite : les modèles testés font environ 100 millions de paramètres et le plus gros essai monte à 725 millions, loin des chatbots actuels. Il n’existe d’ailleurs pas de NCM généraliste : chaque tâche, du résumé à la traduction en passant par le Sudoku, a son propre modèle entraîné séparément.
Les auteurs listent eux-mêmes d’autres défauts : la pyramide a une profondeur fixe, si bien que même une réponse courte la traverse en entier, et le texte présente parfois des raccords maladroits entre étages.
La compression initiale glisse aussi de rares erreurs sur les noms et les chiffres, « Melbourne » pouvant revenir en « Brisbane » et « 1957 » en « 1956 ». Pour écrire de l’information factuelle, ce n’est pas un détail.
Écrire le plan avant les mots donne de bons résultats sur de petits modèles et des tâches ciblées. Reste à savoir si l’avantage tiendra à la taille d’un vrai assistant…

