# Mistral commence à rattraper son retard sur l’IA avec Mistral Large 4
**Date:** 7 octobre 2026
**Source:** [PIX GEEKS](https://pix-geeks.com)
**Catégories:** [High-Tech](https://pix-geeks.com/tech/) > [Intelligence Artificielle](https://pix-geeks.com/tech/intelligence-artificielle/)
**Marques:** [Mistral](https://pix-geeks.com/marque/mistral/)
**Entités secondaires:** Intangible: [Intelligence Artificielle](https://www.wikidata.org/wiki/Q11660)
**Mistral AI a lancé le 6 octobre 2026 la préversion de Mistral Large 4, un modèle d’environ 1 000 milliards de paramètres dont 49 milliards sont actifs. Il passe de 9 à 38 sur l’indice d’Artificial Analysis par rapport à Mistral Large 3. Ses poids sont promis pour la fin du mois.**
Dans [son annonce](https://mistral.ai/news/mistral-large-4/), Mistral surnomme son modèle « le Chonk ». Il est accessible depuis le 6 octobre sur l’API, via Mistral Studio. Mistral l’a entraîné de zéro sur 3 800 GPU NVIDIA Grace Blackwell, dans ses centres de données européens, avec des données multilingues couvrant plus de 160 langues. Les poids ne sont en revanche pas encore publiés : Mistral les promet d’ici la fin du mois, avec des détails sur l’architecture et sur le post-entraînement.
[Post X](https://x.com/MistralAI/status/2107457414387622310)
## Mistral Large 4 score 38 sur Artificial Analysis, contre 9 pour Large 3
Le saut est considérable. Sur l’[Intelligence Index d’Artificial Analysis](https://artificialanalysis.ai/articles/mistral-large-4-france-ai), Mistral Large 4 obtient 38, **comme [GPT-6](https://pix-geeks.com/gemini-4-argon/) Luna** et à un point de DeepSeek V4.1 Flash, à 39. Mistral Large 3, sorti en décembre 2025, plafonnait à 9. Artificial Analysis y voit le modèle le plus intelligent venu d’ailleurs que des États-Unis et de la Chine.
Mais cette formule trace un périmètre étroit. Sur le même classement, Claude Opus 5.5 est à 58 et GPT-6 Astra à 53, tandis que GLM-5.3, à 45, et Kimi K3, à 44, restent eux aussi devant Mistral.
### Mistral Large 4 face aux principaux modèles IA
| Modèle | Artificial Analysis | Prix entrée / sortie* | Contexte | Poids téléchargeables |
| --- | --- | --- | --- | --- |
| **Claude Opus 5.5** | **58** | \4$ / 20 $ | \1million | Non |
| **GPT-6 Astra** | **53** | 10 $ / 50 $ | \1million | Non |
| **GLM-5.3** | **45** | 1,40 $ / 4,40 $ | \1million | Oui |
| **Kimi K3** | **44** | \3$ / 15 $ | \1million | Oui |
| **DeepSeek V4.1 Flash** | **39** | 0,30 $ / 1,20 $ | \1million | Oui |
| **Mistral Large 4 Preview** | **38** | 1,36 $ / 4,18 $ | \1million annoncé** | Fin octobre 2026 |
| **GPT-6 Luna** | **38** | 0,10 $ / 0,50 $ | \1million | Non |
\*Prix en dollars par million de tokens en entrée et en sortie, hors remises et cache. ** La documentation de Mistral annonce 1 million de tokens, tandis qu’Artificial Analysis mesure une fenêtre d’environ 524 000 tokens sur la préversion testée.
Le tableau montre surtout que Mistral Large 4 ne rejoint pas encore les modèles de pointe d’Anthropic et d’OpenAI : il reste 15 points derrière GPT-6 Astra et 20 points derrière Claude Opus 5.5 sur l’indice d’Artificial Analysis. Il se situe plutôt dans le groupe des meilleurs modèles à poids ouverts, à un point de DeepSeek V4.1 Flash, six points derrière Kimi K3 et sept derrière GLM-5.3. Son principal handicap est pour l’instant son prix : DeepSeek obtient un score légèrement supérieur pour une API facturée environ quatre fois moins cher en entrée et trois fois et demie moins cher en sortie.
Simon Willison, qui a soumis le modèle à son test du pélican à vélo, note que l’API ne propose que deux niveaux de raisonnement, « none » et « high ». Le second a dessiné un meilleur pélican avec moins de tokens que le premier, 2 717 contre 3 275.
## Mistral Large 4 : 82 % sur CyberGym, mais des rivaux refusent le test
C’est le terrain sur lequel Mistral insiste le plus. L’un des tests de l’indice cyber consiste à reproduire une vulnérabilité réelle d’un logiciel open source puis à la corriger, et le modèle y obtient 82 %, le meilleur score de la liste. Artificial Analysis situe ce résultat sur CyberGym-E2E-AA, devant MiMo-V2.6-Pro, à 79 %, et GPT-6 Luna, à 78 %.
Sur l’indice cyber complet, le résultat est plus mesuré : 50, au niveau de GLM-5.3-Flash et derrière MiMo-V2.6-Pro, à 56. Mistral range pourtant son modèle parmi les cinq premiers au monde, et le graphique d’Artificial Analysis le montre en effet cinquième, à égalité avec GLM-5.3-Flash.
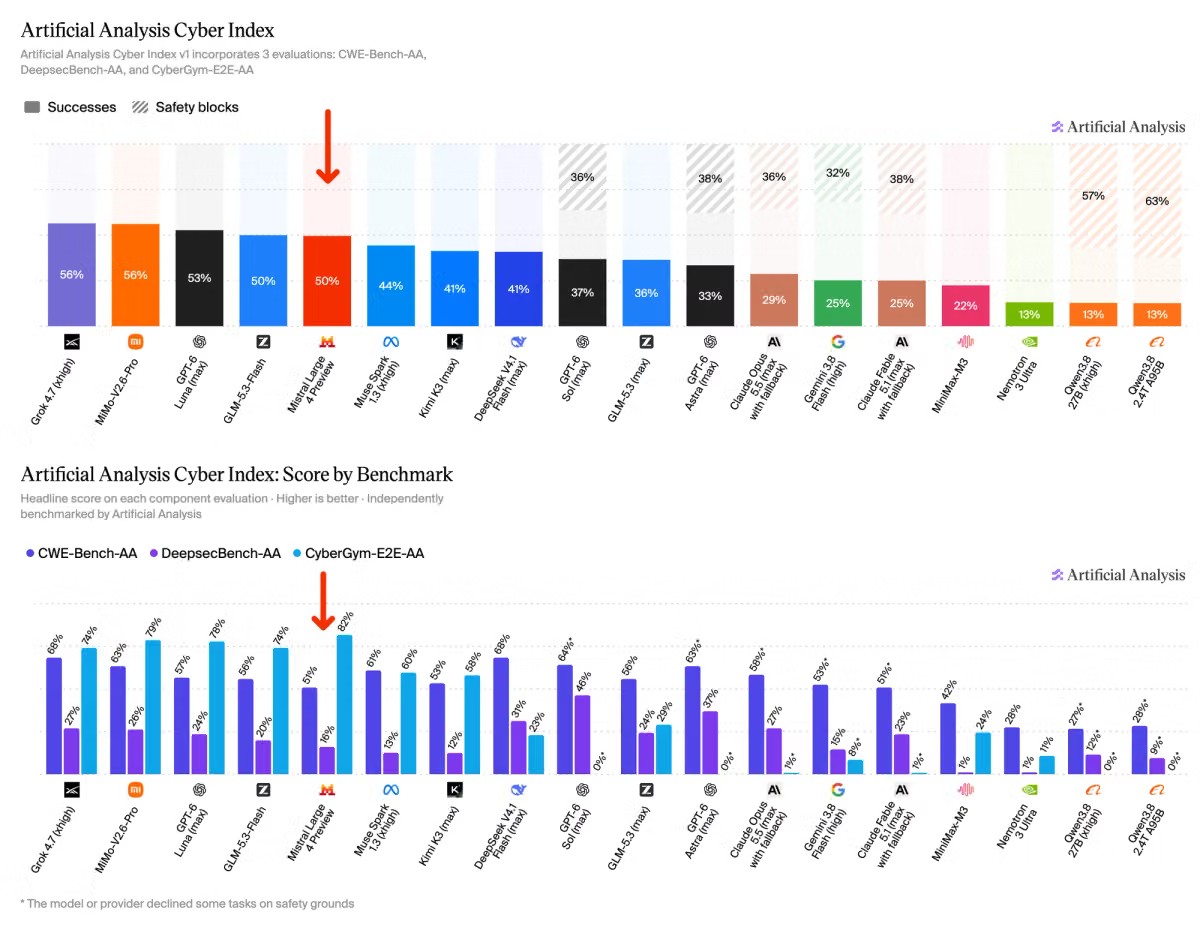
Reste un point à lire de près. Mistral souligne que Claude Opus 5.5 et GPT-6 Astra tombent près de zéro sur ce test parce qu’ils refusent la tâche. Le graphique d’Artificial Analysis le confirme : 1 % et 0 %, avec une mention de refus pour raison de sécurité. Un 0 % peut donc traduire un refus plutôt qu’une incapacité.
Mistral défend l’idée qu’un modèle ouvert évite de perdre l’accès à une capacité en pleine gestion d’incident. Il affirme aussi que son taux de refus sur les requêtes cyber malveillantes dépasse celui de tous les modèles ouverts testés. En attendant les poids, des responsables de la cybersécurité, des partenaires choisis et des autorités étatiques testent une version à modération réduite et à capacités cyber étendues.
Que deviendra cet équilibre quand les poids seront en ligne ?
## Large 4 face à Vals AI : 22,73 % sur Terminal-Bench 4, contre 28,3 % annoncé
Sur le code, l’écart entre l’annonce et la mesure indépendante est net. Mistral revendique 61,7 % sur DeepSWE v1.1 et 28,3 % sur Terminal-Bench 4. [Vals AI](https://www.vals.ai/models/mistralai_mistral-large-4) relève 22,73 % sur ce dernier test, soit la 20e place sur 44, et classe le modèle 32e sur 44 sur son indice général, avec 48,05 %. Nous n’avons trouvé aucune explication à cette différence dans les pages consultées. Une configuration d’évaluation distincte est possible, mais ce n’est qu’une hypothèse.
Vals AI relève tout de même un point fort : la 6e place sur 75 modèles au Harvey’s Legal Agent Benchmark, avec 15,83 %, un terrain juridique que Mistral met aussi en avant.
Pour résumer ce que les tiers ont vérifié, ou non :
- Confirmé par Artificial Analysis : 38 sur l’indice général et 82 % sur CyberGym-E2E-AA
- Écart non expliqué : 28,3 % annoncé sur Terminal-Bench 4, contre 22,73 % mesuré par Vals AI
- Sans mesure indépendante dans les sources consultées : 93 % sur Cybench, 42 % sur Dense 200, devant GPT-6 Astra à 41 %, et 61,7 % sur DeepSWE v1.1
## Prix de Mistral Large 4 : 1,13 $ par tâche, plus de 4 fois ses rivaux ouverts
Mistral facture [1,36 $ le million de tokens en entrée et 4,18 $ en sortie](https://docs.mistral.ai/models/mistral-large-4-0), avec une remise de 50 % pendant les deux premières semaines, qui ramène les prix à 0,68 $ et 2,09 $. Artificial Analysis calcule 1,13 $ par tâche de son indice au tarif standard. GLM-5.3-Flash et DeepSeek V4.1 Flash, deux modèles ouverts de score voisin, à 42 et 39, sont à 0,25 $ et 0,27 $. Avec la remise, on descend à 0,57 $, ce qui reste plus cher.
Le prix du million de tokens ne dit donc pas tout, car si vous comptez déployer le modèle, ce qui compte, c’est ce qu’il consomme pour finir une tâche. Un autre écart reste à clarifier : la documentation de Mistral affiche 1 million de tokens de contexte, quand Artificial Analysis et Vals AI retiennent 512 000.
Mistral présente Large 4 comme le premier jalon d’une feuille de route financée par sa série D de 3 milliards d’euros. Elle assure que l’entraînement, toujours en cours, doit apporter des progrès rapides dans les semaines et les mois à venir. Le modèle publié à la fin du mois pourrait donc différer de celui qui a été mesuré cette semaine, ce qui reste une hypothèse et non une annonce. Reste à savoir si les chiffres de la préversion résisteront aux poids publics et aux testeurs indépendants…
---
**Article précédent:** [ChatGPT va marquer ses textes en Europe : cette astuce fait tomber la détection à 17 %](https://pix-geeks.com/chatgpt-marquage-texte-europe/)